Intégrer l’IA dans un logiciel sans mettre en danger la confidentialité des données, c’est décider ce que le modèle a le droit de voir, ce qu’il a le droit de faire, et qui contrôle le résultat. Les fuites viennent rarement du modèle lui-même : elles viennent de données envoyées sans tri, de droits d’accès oubliés et d’une IA à qui l’on a laissé trop d’autonomie. Ces trois points se règlent à la conception, avant la première ligne de code.
Beaucoup d’éditeurs et d’entreprises veulent ajouter une fonction d’IA à leur produit ou à leur outil interne, et hésitent à cause des données clients. Voici les risques concrets, les règles en France et en Suisse, et les choix de conception qui permettent d’avancer sans exposer ce qui doit rester protégé.
Pourquoi l’IA expose-t-elle les données d’un logiciel ?
Une fonction d’IA générative fonctionne en envoyant du texte à un modèle et en affichant ce qu’il répond. Tout le risque tient dans ces deux trajets : ce qui part, et ce qui revient.
Ce que voit réellement le modèle
À chaque appel, le modèle reçoit bien plus que la question de l’utilisateur. Il reçoit les consignes écrites par l’éditeur, les documents ou les fiches qu’on lui joint pour répondre, et souvent une partie de l’historique de l’échange.
Dans un logiciel métier, ces éléments contiennent vite des noms de clients, des montants, des échanges internes ou des données de santé. Ce qui semblait une simple aide à la rédaction transporte en réalité une partie de votre base.
La première question à poser n’est donc pas « quel modèle choisir ? », mais « qu’est-ce qui part, vers qui, et pour quoi faire ? ». Sans réponse écrite, personne ne peut garantir ce que contient un appel.
Le fournisseur du modèle peut aussi conserver ces échanges pendant un temps, dans ses journaux techniques. C’est un point à vérifier dans ses conditions, avant le premier essai avec des données réelles.
Des réponses qui en disent trop
Le risque ne s’arrête pas à l’envoi. L’OWASP, organisation de référence en sécurité applicative, classe la divulgation d’informations sensibles parmi les principaux risques des applications fondées sur les grands modèles de langage, dans sa fiche LLM02:2025 Sensitive Information Disclosure.
Elle cite les données personnelles, financières et de santé, les informations confidentielles de l’entreprise, les identifiants de sécurité et les documents juridiques. La même fiche précise qu’une consigne interdisant au modèle de révéler certaines données n’est pas toujours respectée, et peut être contournée.
Autrement dit, demander poliment au modèle de se taire ne suffit pas. Ce qu’il ne doit pas révéler, il ne doit pas le recevoir.
Le risque augmente quand plusieurs clients partagent la même fonction. Une réponse construite à partir des documents d’un client ne doit jamais apparaître chez un autre.
Des documents qui donnent des ordres
Le troisième risque est moins connu. L’OWASP décrit dans sa fiche LLM01:2025 Prompt Injection l’injection indirecte : un contenu externe, comme une page web ou un fichier, peut contenir des instructions que le modèle interprète et qui modifient son comportement.
Dans un logiciel qui résume des e-mails entrants ou analyse des pièces jointes, un document piégé peut ainsi tenter de faire sortir des informations ou de déclencher une action. L’OWASP précise que ces instructions n’ont même pas besoin d’être lisibles par un humain.
Les fonctions qui lisent du contenu venu de l’extérieur méritent donc une attention particulière : e-mails entrants, formulaires publics, documents déposés par des tiers.
Plus l’IA peut agir dans vos systèmes, plus ce risque pèse. C’est l’une des raisons de garder une personne dans la boucle, comme on le verra plus loin.
IA et confidentialité des données : quelles règles s’appliquent ?
Aucune loi n’interdit d’utiliser l’IA sur des données d’entreprise. Mais les règles existantes s’y appliquent pleinement, en France comme en Suisse.
En France et dans l’Union européenne
Le RGPD s’applique dès qu’une fonction d’IA traite des données personnelles : finalité définie, minimisation, sécurité, information des personnes. La CNIL a publié des fiches pratiques sur l’IA qui expliquent comment appliquer ces règles au développement des systèmes d’IA.
Pour un éditeur ou une entreprise qui intègre un modèle existant, le point le plus concret reste le contrat avec le fournisseur du modèle. Il traite des données pour votre compte : il est en général votre sous-traitant, avec les clauses que cela impose.
Nous détaillons ces clauses, et ce qu’il faut demander à un éditeur, dans notre article logiciel métier sur mesure ou SaaS. Les mêmes questions valent pour un fournisseur de modèle : où sont traitées les données, sont-elles conservées, servent-elles à entraîner le modèle.
Si la fonction prend des décisions qui touchent des personnes, comme un tri de candidatures, le cadre devient plus strict. Faites-la relire par un juriste avant le développement.
En Suisse, la loi actuelle s’applique déjà
Le Préposé fédéral à la protection des données et à la transparence l’a rappelé : la loi actuelle sur la protection des données est directement applicable à l’IA. Les fabricants, fournisseurs et exploitants de systèmes d’IA doivent rendre transparents la finalité, le fonctionnement et la source des données traitées.
Le PFPDT ajoute qu’un utilisateur qui échange avec un modèle de langage a le droit de savoir s’il s’adresse à une machine, et si les données qu’il saisit sont réutilisées, par exemple pour améliorer le système.
Pour un logiciel utilisé à Genève ou à Lausanne, cela se traduit dans l’interface : une mention claire de la fonction d’IA, et une information honnête sur ce que deviennent les données saisies.
Une entreprise française qui sert des clients suisses peut être concernée par les deux cadres. Mieux vaut concevoir une fois pour les deux que corriger après coup.
Comment concevoir une intégration qui protège les données ?
L’ANSSI a publié en avril 2024 un guide de recommandations de sécurité pour un système d’IA générative. Sa recommandation R7 est claire : prendre en compte la confidentialité des données dès la conception. Voici comment cela se traduit dans un produit.
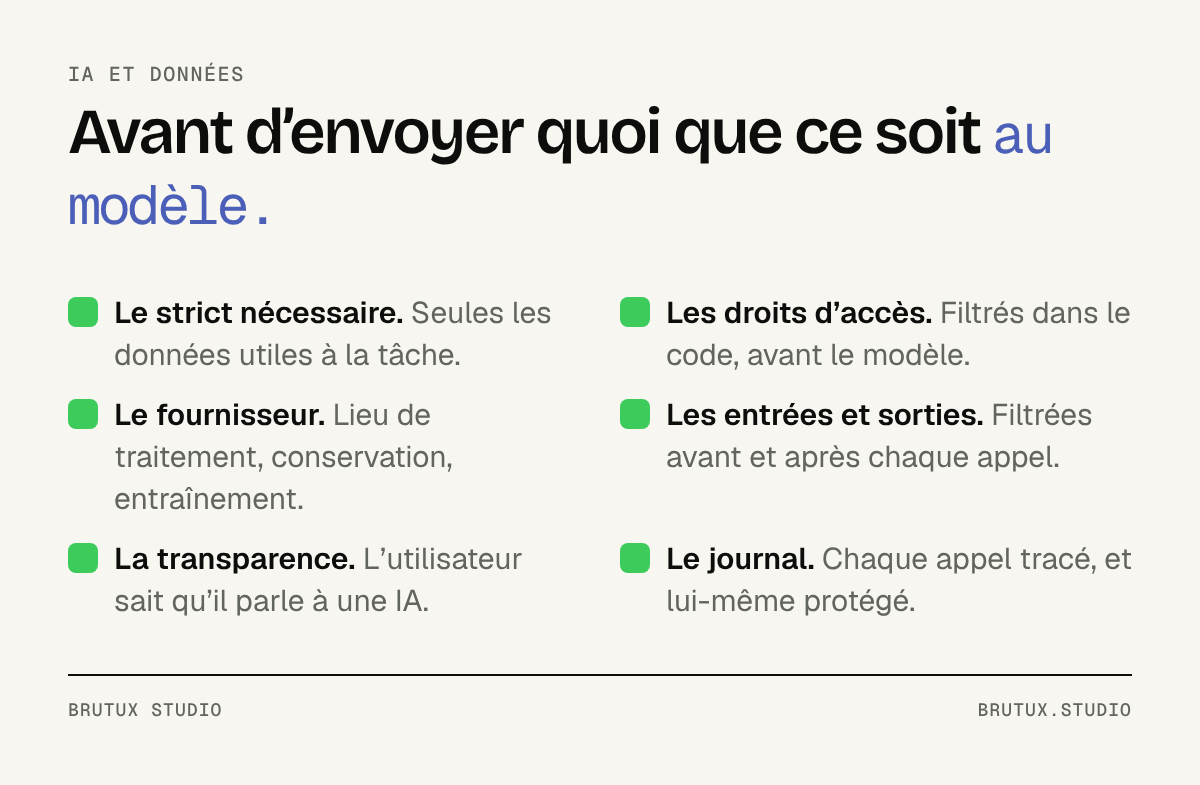 Les points à régler avant d’envoyer quoi que ce soit à un modèle.
Envoyer moins, et seulement ce qui sert
Pour chaque fonction, listez les données dont le modèle a réellement besoin pour accomplir la tâche. Un résumé de ticket n’a pas besoin de l’adresse du client ; une suggestion de catégorie n’a pas besoin du montant de la facture.
Quand une donnée personnelle n’apporte rien au résultat, retirez-la ou remplacez-la avant l’envoi. Certaines fonctions peuvent ainsi fonctionner sans transmettre aucune donnée personnelle.
Écrivez ces règles noir sur blanc, fonction par fonction. Elles serviront aux développeurs, à votre délégué à la protection des données et aux clients qui poseront la question.
Respecter les droits d’accès existants
Votre logiciel sait déjà qui a le droit de voir quoi. L’IA ne doit pas devenir un raccourci qui contourne ces droits. La recommandation R8 de l’ANSSI demande de prendre en compte le besoin d’en connaître dès la conception.
C’est particulièrement vrai pour les assistants qui interrogent une base documentaire. Si un collaborateur n’a pas accès à un dossier, l’assistant ne doit pas pouvoir le lui résumer : les documents doivent être filtrés selon ses droits avant d’être confiés au modèle.
Ce filtrage se fait dans votre code, pas dans la consigne donnée au modèle. Une consigne se contourne ; une requête qui ne renvoie pas le document, non.
Filtrer ce qui entre et ce qui sort
La recommandation R25 de l’ANSSI préconise de filtrer les entrées et les sorties des utilisateurs. Côté entrée, on repère les données qui ne devraient pas partir et les tentatives de détourner la fonction.
Côté sortie, on vérifie que la réponse ne contient pas d’informations qui ne devraient pas s’afficher, avant de la montrer à l’utilisateur. Ce contrôle protège aussi contre les injections indirectes venues d’un document.
Aucun filtre n’est parfait. Il s’ajoute aux autres mesures, il ne les remplace pas.
Ces filtres se testent comme le reste du code, avec des exemples concrets de ce qu’ils doivent bloquer et de ce qu’ils doivent laisser passer.
Quel rôle laisser à l’IA dans le logiciel ?
Plus une IA est autonome, plus une erreur ou une injection peut coûter cher. Le niveau d’autonomie se choisit fonction par fonction, selon ce que coûterait une erreur.
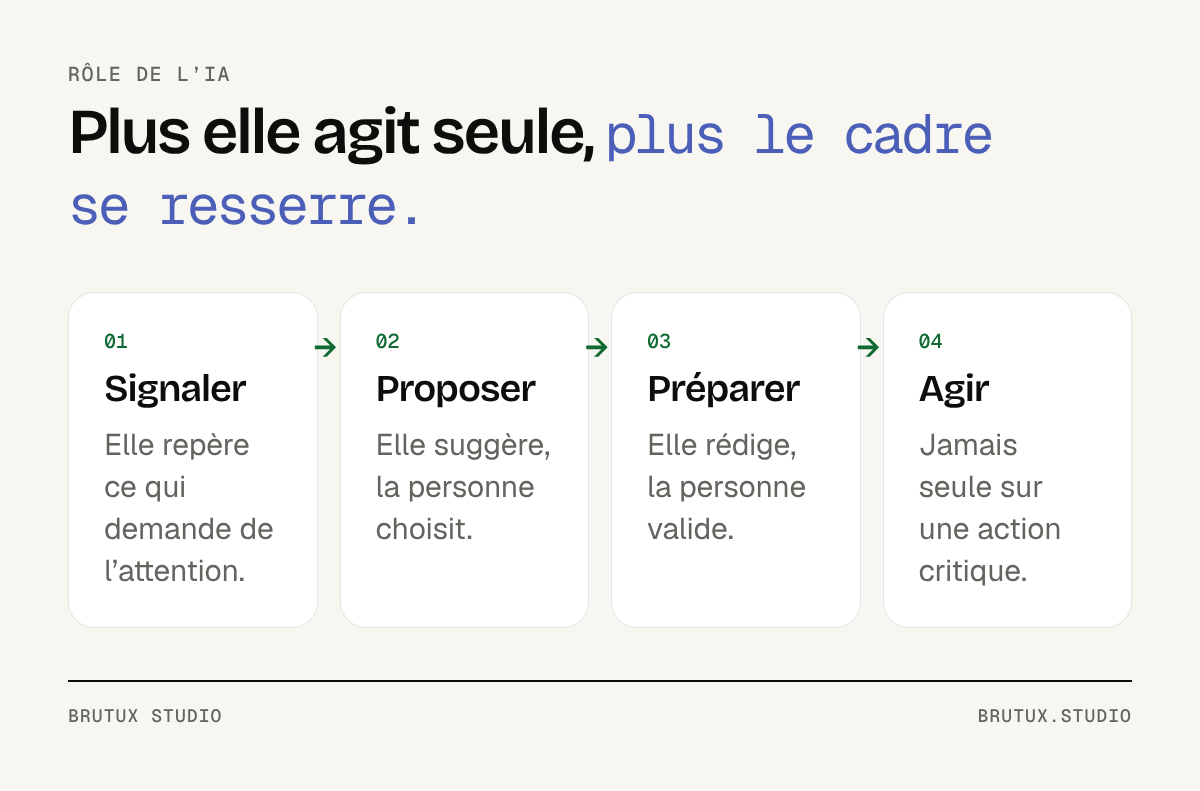 Plus l’IA agit seule, plus le cadre doit être strict.
Proposer plutôt qu’agir
La recommandation R9 de l’ANSSI demande de proscrire l’usage automatisé de systèmes d’IA pour des actions critiques, qu’elles soient critiques pour le métier, comme une transaction ou un contenu publié, ou pour l’infrastructure. L’OWASP recommande de son côté une approbation humaine pour les actions à haut risque et le principe du moindre privilège.
Dans la pratique, l’IA prépare et la personne valide. Une réponse au client est rédigée, puis relue avant envoi ; une écriture comptable est proposée, puis confirmée.
Ce choix ralentit parfois un peu l’utilisateur. Il évite surtout qu’une erreur plausible parte chez un client sans que personne l’ait vue.
C’est ainsi que fonctionnent les produits que nous concevons. Sur le projet mené avec Metroscope pour EDF, Victor Michel, fondateur du studio, a conçu des alertes accompagnées d’actions recommandées, en laissant la décision aux équipes. Dans les outils du studio, la personne relit et valide avant toute publication.
Prévoir un mode dégradé
Un service d’IA peut être indisponible, ralentir ou se mettre à répondre de travers. La recommandation R15 de l’ANSSI conseille de prévoir au minimum une procédure de contournement pour que les utilisateurs puissent continuer à travailler.
Concrètement, la fonction d’IA doit pouvoir être coupée sans bloquer le logiciel. L’utilisateur garde le moyen de faire la tâche à la main, et l’équipe peut désactiver la fonction pour un client ou pour tous en quelques minutes.
C’est aussi une protection contre un fournisseur qui changerait ses conditions : la fonction peut être suspendue le temps de trouver une autre solution.
Garder une trace de chaque appel
La recommandation R29 de l’ANSSI demande de journaliser l’ensemble des traitements réalisés au sein du système d’IA. Sans journal, impossible de savoir après coup ce qui a été envoyé, ce que le modèle a répondu et ce que l’utilisateur en a fait.
Ce journal sert aussi à améliorer la fonction : les suggestions acceptées, modifiées ou rejetées disent où l’IA aide vraiment. Il doit lui-même être protégé et conservé selon une durée définie, puisqu’il contient des données.
Comment vérifier avant d’ouvrir la fonction à tous ?
Une démonstration réussie ne prouve rien sur la confidentialité. Deux étapes permettent de vérifier avant de généraliser.
Tester sur des cas réels, y compris malveillants
Constituez un jeu de cas tirés du quotidien, avec les cas difficiles, et ajoutez des tentatives volontaires : un document contenant des consignes cachées, une question qui cherche des informations d’un autre client, une demande hors du rôle prévu.
Vérifiez pour chacun ce que le modèle reçoit et ce qu’il répond. Rejouez ce jeu à chaque changement de modèle, de fournisseur ou de consigne, car un comportement sûr peut changer d’une version à l’autre.
Faites intervenir quelqu’un qui n’a pas conçu la fonction. Il trouvera plus facilement les questions que les concepteurs n’avaient pas imaginées.
Notre article sur la valeur de l’IA dans un SaaS B2B détaille comment choisir la tâche à assister ; ce jeu de tests vient juste après, avant le développement.
Ouvrir par étapes
Commencez avec un petit groupe d’utilisateurs volontaires, sur des données réelles mais un périmètre limité. Suivez le journal, les retours et les incidents pendant quelques semaines.
N’élargissez qu’une fois les règles sur les données vérifiées en conditions réelles. Prévenez vos clients de l’arrivée de la fonction, de ce qu’elle fait et de ce qu’elle ne fait pas.
Gardez la possibilité de désactiver la fonction pour un client qui le demande. Certains grands comptes voudront mener leur propre analyse avant de l’ouvrir à leurs équipes.
Pour les entreprises de Genève et de Suisse romande, nous menons ces cadrages en rendez-vous et à distance, comme le présente notre page consultant IA à Genève.
Le plus simple pour démarrer reste d’en parler : en 30 minutes, nous regardons la fonction que vous envisagez et les données qu’elle toucherait.
Sources
- ANSSI, Recommandations de sécurité pour un système d’IA générative (29 avril 2024)
- OWASP, LLM01:2025 Prompt Injection
- OWASP, LLM02:2025 Sensitive Information Disclosure
- Préposé fédéral à la protection des données et à la transparence, La loi actuelle sur la protection des données est directement applicable à l’IA
- CNIL, Les fiches pratiques IA